Personal Productivity System
工作时间规划器
把“今天想做什么”改写成一个容量规划问题,用历史耗时、精力曲线和预留缓冲生成可执行的日计划。
Python · CLI · JSON · stdlib-only
打开演示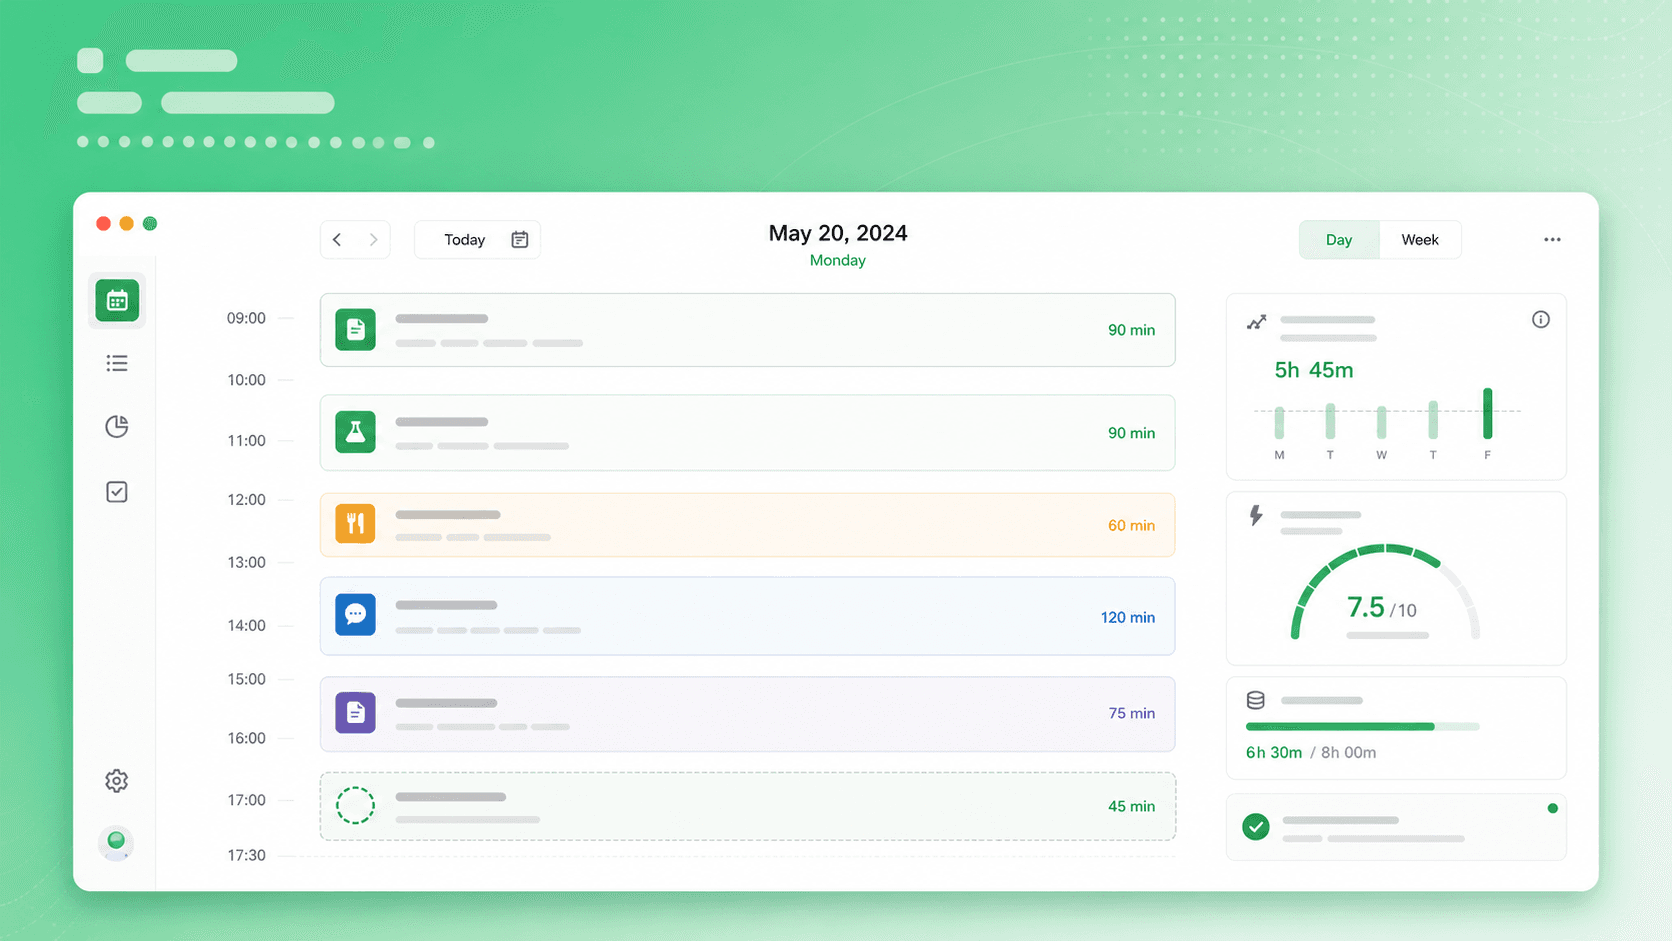
这个工具来自一个很个人的问题:待办写得越完整,一天反而越容易被排得不现实。真正需要的不是更长的清单,而是一个愿意承认时间、精力和估时误差的计划器。
它不连接日历,也不靠模型替我决定优先级。任务、历史记录和规则都保存在本地,以一组简单 CLI 命令完成分析、计划、记录和建议。
我把它当成一个小型反馈系统:任务提供当前需求,历史耗时修正估计,工作窗口和精力定义容量,真实执行结果再回到历史数据。计划不是一次性生成的答案,而是随着个人记录逐步改善的下一次假设。
第一条规则:不要把一天排满
旧方法通常从任务总量出发:还有四件事,就努力把四件事都塞进去。规划器反过来从可用窗口出发,先扣除休息和缓冲,再看剩余容量能承载什么。
这意味着某些任务会被推迟。对我而言,这不是计划失败,而是计划终于开始诚实地表达容量。
容量不仅是起止时间之差。固定会议会切碎连续窗口,任务切换需要成本,午后和早晨的认知状态也不同。因此工具同时保留总容量与可用时间块,不会因为一天还剩 90 分钟,就假设任意 90 分钟任务都能被完整放入。
| 输入 | 如何影响计划 |
|---|---|
| 工作窗口 | 定义今天真正可以安排的起止时间。 |
| 历史中位数 | 比单次最快纪录更适合作为下一次估时。 |
| 精力等级 | 高认知任务优先进入状态较好的时段。 |
| 休息与缓冲 | 先占位置,而不是等任务排完后再寻找空隙。 |
四个命令,对应四种不同动作
读、写和建议被刻意分开。`analyze` 不修改数据,`log` 只追加记录,`recommend` 默认只展示建议,只有明确传入写入选项才更新历史估时。这样每次状态变化都有清楚的入口。
这种命令拆分对应四种权限:分析历史是只读行为,生成计划只创建当天方案,记录耗时只能追加事实,推荐估时只是计算建议。将它们合并成一个自动更新命令会更方便,却会让一次查看同时改变未来计划,难以判断估时为什么发生变化。
所有命令都使用同一套本地 JSON 数据契约,并在写入前校验任务 ID、时间格式和数值范围。追加记录保留旧数据,推荐写回则需要显式参数,使“观察”和“改变”始终是两个不同动作。
planner analyze # 只读历史记录planner plan # 生成当天时间块planner log # 追加真实耗时planner recommend # 建议新的历史估时一份日计划是怎样长出来的
- 01
读取约束
先读取工作起止、固定事项、午休、最小休息和缓冲比例,形成可用时间块;无效或重叠窗口会在规划前被指出。
- 02
估时
优先使用同类任务的历史中位数;样本不足时回退到显式默认值,同时保留估时来源和置信度。
- 03
拆分
超过单个专注块的复合任务按阶段拆成可独立收尾的小段,记录父任务与剩余工作,避免第二天无法恢复上下文。
- 04
匹配
先根据认知负荷匹配精力窗口,再在同类任务中比较优先级和截止约束;高优先级不会自动覆盖基本休息。
- 05
留白
休息、切换成本和机动时间预先占位。容量不足时明确延后任务,而不是压缩每个时间块制造一份不可能执行的计划。
- 06
复盘
完成后追加真实开始、结束、净耗时和中断说明,为下一次估计提供样本;计划值和事实值并列保留。
规划从容量开始,而不是从愿望清单开始
工具先计算今天真正可用的时间,再决定能装入哪些任务。午休、固定事项和机动缓冲会优先占据容量,而不是等所有任务排完后才从缝隙里寻找位置。
如果剩余容量不足,低优先任务会明确延后。这个结果看起来没有“全部安排”那么积极,却更接近真实执行,也让临时变化出现时仍有调整空间。
缓冲不是固定浪费时间,而是对不确定性的预算。工作日越碎、临时沟通越多,越需要保留更高比例;相对稳定的深度工作日则可以降低。工具把缓冲作为可配置规则,并在结果中单独显示,让使用者知道哪些空白是有意保留,而不是遗漏。
usable_capacity = work_window - fixed_events - breaks - change_bufferplanned_work <= usable_capacity为什么使用历史中位数,而不是最快纪录或平均值
最快纪录适合描述理想状态,却不适合承诺下一次;平均值又容易被少数异常长任务拉高。历史中位数对极端值更稳定,也更容易向自己解释:过去一半记录比它快,一半比它慢。
样本不足时不会伪装成精确预测,而是回退到明确的默认估时并标记低置信度。随着真实耗时增加,推荐值逐步替代默认值,但写回历史配置仍然需要显式确认。
任务历史也不会只按标题匹配。记录使用稳定任务类型与可选标签,例如分析、写作、沟通或重复执行,使新的具体任务能够借用同类历史,同时避免把完全不同的工作混在同一组里。分类规则保持简单透明,使用者可以看到本次估时参考了哪些记录。
| 估时来源 | 使用方式 |
|---|---|
| 无历史记录 | 使用任务类型默认值,并标记需要积累样本。 |
| 少量记录 | 展示历史范围,暂不自动覆盖默认估时。 |
| 稳定样本 | 采用中位数作为计划基线。 |
| 异常耗时 | 保留原始记录,但不让单次极端值主导计划。 |
任务拆分与精力匹配,比简单排序更重要
一个 90 分钟的分析任务不能因为优先级高,就直接占据任意连续时段。规划器会把超过专注块上限的任务拆成能够独立收尾的阶段,再把高认知部分放入精力较好的窗口,把低负荷沟通放到状态较弱的时段。
拆分不是机械切成相等分钟数,而是尽量保留阶段边界,让每个时间块结束时都能留下可恢复的工作状态。
如果任务没有可识别的阶段,工具会给出建议拆分而不是擅自改写任务。人可以接受、调整或保持整体任务;规划器只在确认后的粒度上安排时间。这避免了为了排程方便而生成一堆没有实际意义的小步骤。
- 先匹配认知负荷,再在同类任务中比较优先级。
- 任务块之间保留切换成本,不把所有空隙都视为可用时间。
- 无法完整容纳的任务被延后或拆分,不通过压缩休息来制造容量。
- 计划与真实耗时形成反馈环,使下一次估时更接近个人节奏。
真实耗时怎样改变下一次计划
每次完成任务后,`log` 只追加一条事实记录:原计划时长、实际净耗时、是否被中断和可选备注。分析命令按任务类型聚合历史,展示样本数、中位数、范围和最近趋势;推荐命令再根据这些统计提出新的默认估时。
建议不会自动覆盖旧值。使用者可以先判断耗时变长是估计偏差、任务范围扩大还是异常中断,再决定是否更新。这样反馈循环吸收真实经验,但不会把一次特殊事件永久写进未来计划。
plan_estimate -> execute -> actual_durationactual_duration -> append_historyhistory -> median + sample_count + rangestatistics -> recommendation -> explicit_acceptaccepted_estimate -> next_plan计划失败时,不只看任务有没有打勾
一天结束后,工具区分四种偏差:估时不准、任务范围变化、外部插入和主动放弃。它们表面上都会表现为“没有按计划完成”,但对应的改进动作完全不同。
估时偏差应修正历史基线,范围变化应改进任务拆分,外部插入应重新评估缓冲,主动放弃则可能说明优先级判断发生变化。复盘的目的不是追责,而是让下一次计划使用更好的假设。
| 偏差类型 | 下一步处理 |
|---|---|
| 实际耗时持续更长 | 检查样本并调整该类任务的估时基线。 |
| 任务做到一半发现范围扩大 | 改进任务定义和阶段拆分,不只增加分钟数。 |
| 临时事项频繁插入 | 提高缓冲或保留专用沟通窗口。 |
| 主动改变优先级 | 记录决策原因,不把它错误解释为执行效率问题。 |
这个工具刻意不做什么
- 不自动读取私人日历或消息,输入范围由使用者明确提供。
- 不使用模型替人决定价值排序,优先级仍然是人的判断。
- 不通过压缩休息提升表面利用率,也不把空白视为待填满缺口。
- 不因为一次异常记录自动改变长期估时,所有配置更新都需要确认。
- 不把计划完成率作为唯一目标,更关注容量假设是否逐渐准确。
公开演示只讲一个普通工作日
Lab 预设四项示例任务。动画会把 90 分钟分析任务拆成两个专注块,把低负荷沟通放到午后,并明确画出午休和 45 分钟缓冲。下载结果是一份 Markdown 日计划,适合直接阅读,也和另外几个表格型项目形成区别。
这一天最终没有被排满:重点任务有明确位置,变化也仍然留有余量。
演示还会显示每个时间块采用的估时来源与安排理由,例如“历史中位数”“高精力窗口”或“保留缓冲”。结果不只是时间表,也是一份可以检查规划逻辑的说明。
Related Lab
查看公开流程演示
载入预设样本,按关键步骤运行,并下载对应的 Sample 结果。
打开演示